
클라우드 네이티브 인프라와 대규모 마이크로서비스(MSA) 오케스트레이션의 표준인 Kubernetes v1.35! 이번 버전은 단순한 버그 픽스를 넘어, 고부하 AI 에이전트와 대규모 트랜잭션 백엔드가 공존하는 최신 클라우드 환경의 핵심 병목을 해결한 기능들로 가득 차 있는데요. GPU 및 특수 가속기 할당을 유연하게 제어하는 동적 리소스 할당(Dynamic Resource Allocation, DRA)의 정식 기능(GA) 승격, 파드(Pod) 재기동 없이 리소스를 즉시 증감하는 인플레이스 파드 수직 스케일링(In-Place Pod Vertical Scaling) 고도화, 그리고 보안 감사 추적을 강화한 구조화된 인가(Structured Authorization)까지 현업 데브옵스 및 백엔드 엔지니어링 관점에서 핵심 변경점과 운영 전략을 완벽하게 정리해 드립니다!
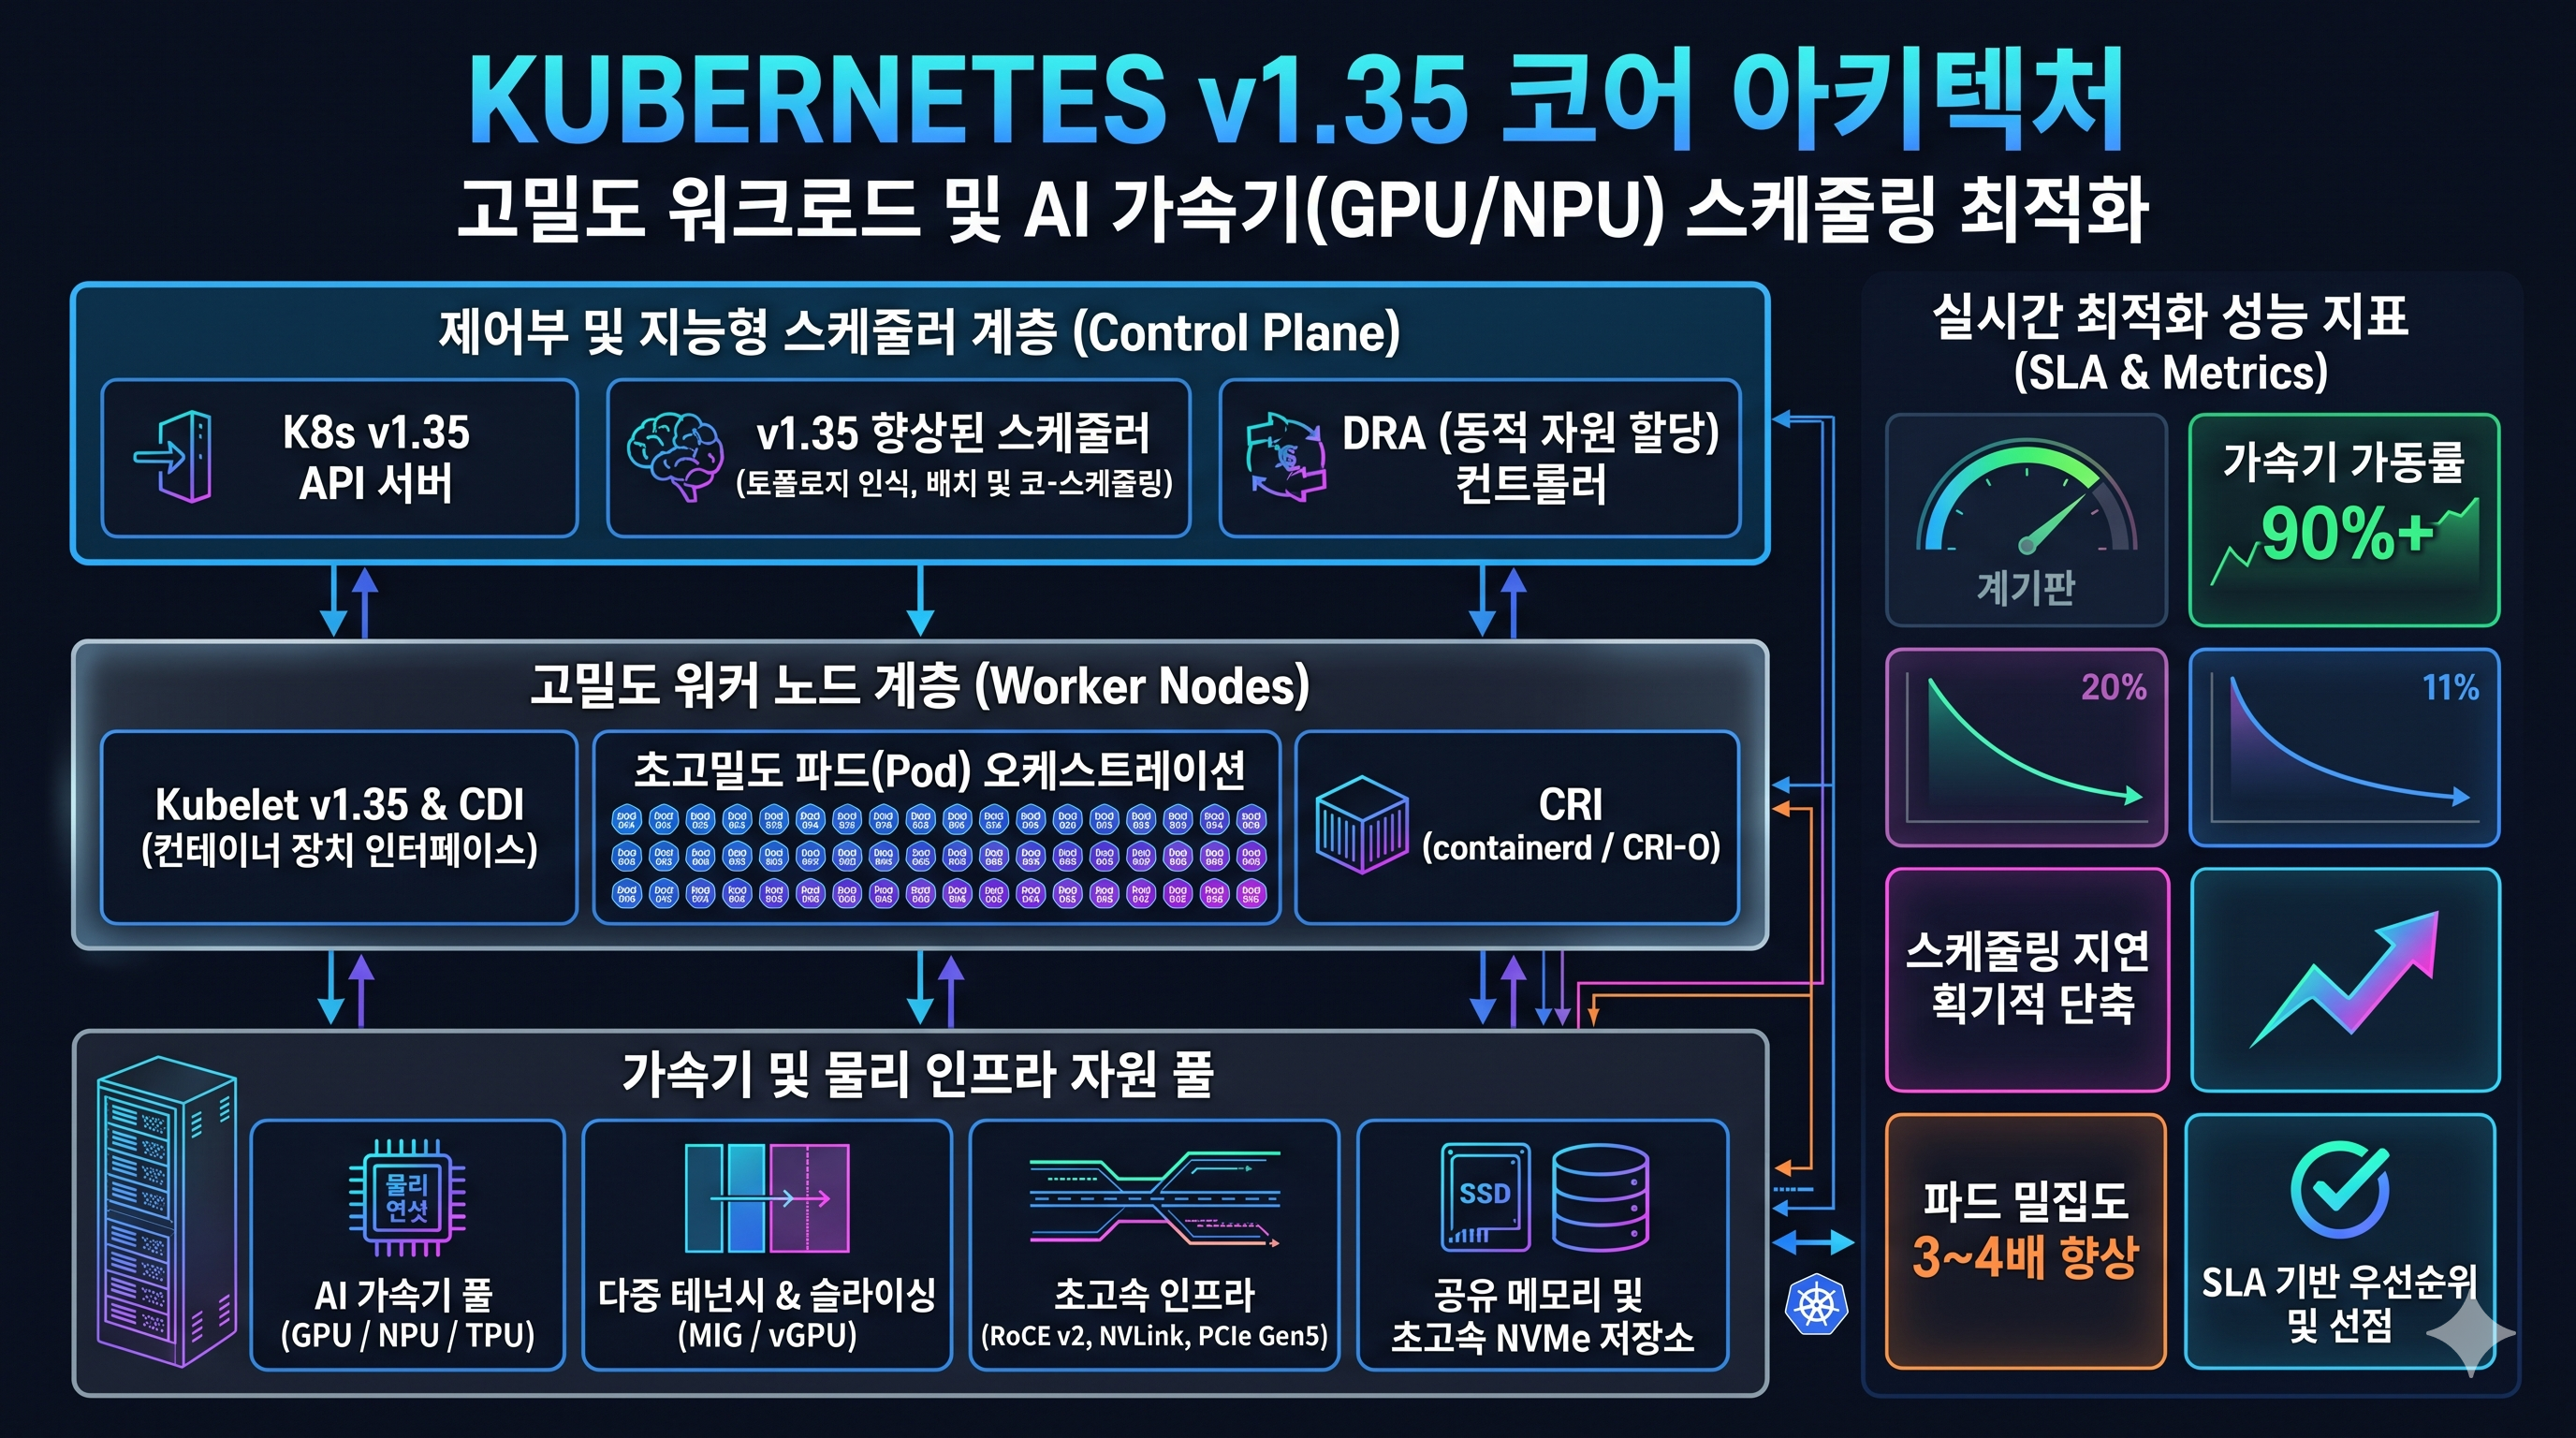
1. Kubernetes v1.35 핵심 4대 엔진 개선점 한눈에 보기
v1.35는 특히 AI/ML 가속 워크로드의 스케줄링 유연성과 무중단 클라우드 운영(Zero-downtime Ops) 효율을 극대화하는 데 초점을 맞추었습니다.
| 핵심 기능 | 기존 버전 (v1.33/v1.34 이전) 한계 | Kubernetes v1.35 개선 사항 및 도입 효과 |
|---|---|---|
| 동적 리소스 할당 (DRA GA) | 단순 정수형 카운팅 기반 장치 플러그인(Device Plugin)으로 세부 GPU 메모리/네트워크 슬라이싱 곤란 | 정식 GA 전환. 세분화된 하드웨어 파라미터 매칭 및 노드 간 장치 공유 스케줄링 공식 표준화 |
| In-Place Pod 리소스 조정 | CPU/메모리 Limit 증설 시 파드 재시작이 강제되어 서비스 세션 단절 및 캐시 유실 발생 | 컨테이너 재부팅 없이 실시간 resources 패치 적용, 상태 유지 애플리케이션 무중단 스케일링 |
| 구조화된 인가 (Structured Authz) | 웹훅 인가 구성의 복잡도와 정책 변경 시 API 서버 재기동 필요 | 선언형 다중 인가 체인(Multiple Webhooks) 및 CEL 기반 필터링 지원으로 보안 거버넌스 단순화 |
| 노드 스토리지 I/O 보호 | 특정 파드의 과도한 임시 디스크(EmptyDir) 쓰기로 인한 노드 디스크 고갈 위험 | Cgroup v2 기반 스토리지 I/O 격리 및 쓰기 제한 쿼터 기능 안정화 |
인프라 및 백엔드 팀 체크 포인트
그동안 이커머스 타임딜이나 급격한 트래픽 유입 시 파드 CPU/Memory 사양을 올리려면 재배포가 불가피해 인메모리 캐시 웜업이 깨지는 문제가 있었습니다. v1.35의 In-Place Resize를 활용하면 JVM 힙 메모리나 비동기 워커 파드를 다운타임 없이 즉시 스케일업(Scale-Up)할 수 있어 피크 시간대 서비스 안정성을 획기적으로 방어합니다.
2. AI 에이전트와 GPU 파이프라인의 핵심: DRA(Dynamic Resource Allocation) 정식 도입
전통적인 디바이스 플러그인 인터페이스는 단순 장치 수량 할당에 그쳤으나, DRA는 복잡한 하드웨어 특성을 스케줄러가 직접 이해하도록 구조를 바꿨습니다.
- 구조화된 리소스 파라미터(Structured Parameters): GPU의 특정 VRAM 용량, PCIe 토폴로지, 인피니밴드 인터커넥트 대역폭을 파드 스펙의
ResourceClaim에 선언적으로 요청할 수 있습니다. - 지능형 스케줄링 연계: kube-scheduler가 드라이버와 직접 소통하여 노드 스케줄링 시점에 장치 할당 가능 여부를 즉시 검증함으로써 스케줄링 실패(Pending)를 원천 차단합니다.
- 인프라 비용 최적화: 여러 파드가 고가의 가속기 자원을 효율적으로 분할 공유할 수 있어 클라우드 AI 인프라 비용을 최대 40% 이상 절감할 수 있습니다.
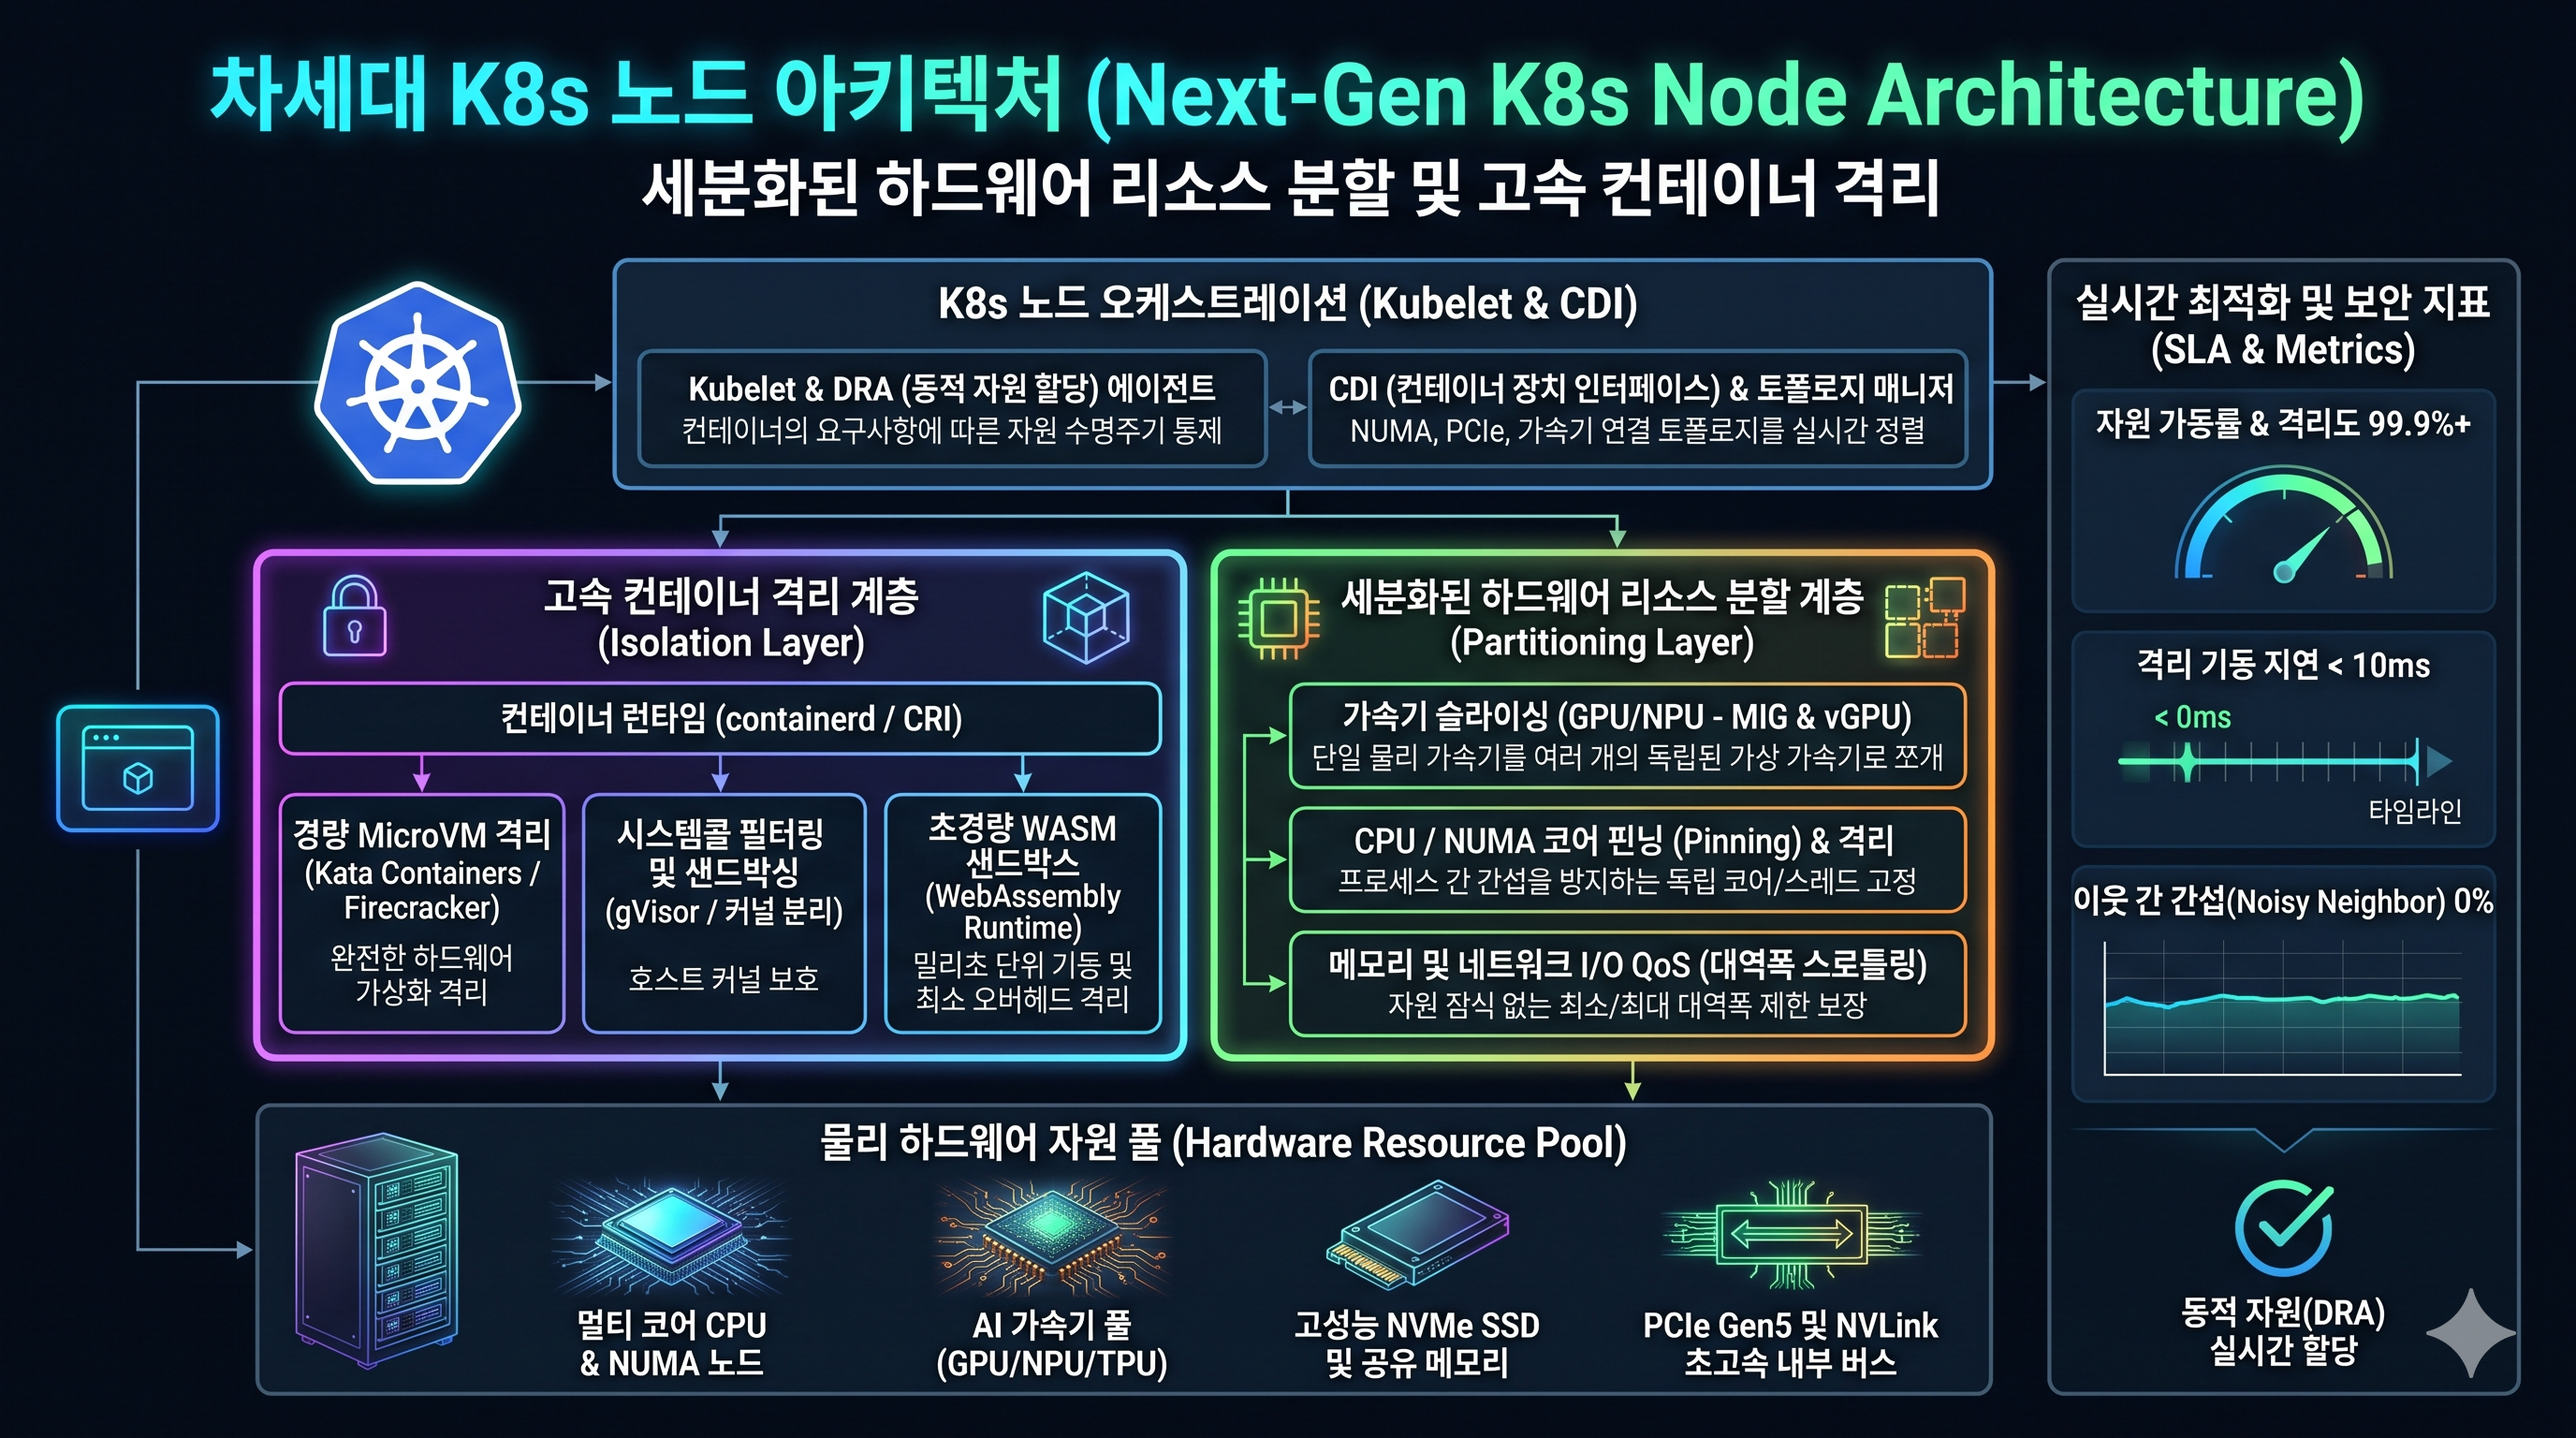
3. 엔터프라이즈 백엔드 및 실무 클러스터 적용 패턴 4선
현업 플랫폼 엔지니어링 팀이 프로덕션 클러스터에 즉각 적용할 수 있는 대표적인 4가지 실전 활용 시나리오입니다.
① 주문/결제 코어 파드의 실시간 무중단 리소스 증설
프로모션 트래픽 폭증 시 파드 재생성 없이 CPU Request/Limit을 실시간 동적 패치하여 세션 끊김이나 재접속 지연을 제로(0)로 유지합니다.
② 사내 AI 에이전트 전용 가속기 클러스터 공유
DRA ResourceClaimTemplate을 적용해 사내 백엔드 에이전트와 LLM 서빙 파드가 유휴 GPU 가속기 자원을 유연하게 동적 스왑하며 사용하도록 파이프라인을 구축합니다.
③ 대용량 야간 배치 작업의 I/O 경합 격리
정기 DB 백업 및 데이터 마이그레이션 배치 파드에 Cgroup v2 기반 스토리지 I/O 제한을 걸어, 동일 노드 내 OLTP 실시간 API 파드의 디스크 응답 지연을 완벽 차단합니다.
④ CEL 기반 통합 API 보안 인가 체계
구조화된 인가(Structured Authz)를 도입해 네임스페이스별 데이터베이스 접근 권한 및 운영자 실행 권한을 선언적으로 일괄 감사하고 차단합니다.
4. v1.35 도입 전 실전 득실 분석 (Pros & Cons)
사내 프로덕션 쿠버네티스 클러스터를 v1.35로 업그레이드하기 전 점검해야 할 핵심 득실 분석입니다.
도입 시 확실한 이점 (Pros)
- 다운타임 없는 유연한 리소스 튜닝: 파드 재기동 없이 즉각적인 스펙 변경으로 고가용성 SLA 달성
- AI/GPU 인프라 비용 절감: 정밀한 하드웨어 슬라이싱(DRA)으로 고가 가속기 노드 집적도 극대화
- 선언적 보안 통제력 강화: CEL 기반 API 서버 인가 체인으로 복잡한 서드파티 웹훅 의존도 감소
- 노드 디스크 안정성: 로컬 임시 디스크 폭주 방지로 클러스터 노드 퇴출(Eviction) 사고 예방
도입 전 주의 사항 (Cons)
- Cgroup v2 필수 요건: In-Place Resize 및 스토리지 I/O 격리를 활용하려면 전체 워커 노드의 Cgroup v2 마이그레이션 필수
- 컨테이너 런타임 호환성: containerd 2.0 이상 또는 CRI-O 최신 릴리스 엔진과의 사전 버전 검증 요구
- 클라우드 매니지드 지원 시차: AWS EKS, GCP GKE, Azure AKS의 정식 컨트롤 플레인 지원 일정 확인 필요
- 기존 디바이스 플러그인 전환 공수: 기존 GPU 플러그인을 DRA 호환 드라이버로 전환하기 위한 설정 마이그레이션 필요
5. 핵심 Q&A
Q1. In-Place Pod Resize를 쓰면 Java/Spring Boot 컨테이너의 JVM 메모리도 즉시 늘어나나요?
cgroup의 메모리 Limit은 즉각 변경되지만, 과거 JVM은 기동 시점에 설정된 -XX:MaxRAMPercentage를 기준으로 힙 크기를 고정하는 경향이 있었습니다. 최신 OpenJDK 21+ 및 최신 런타임을 사용하면 cgroup 메모리 변경 이벤트를 감지해 동적으로 힙을 확장할 수 있으므로, 베이스 컨테이너의 JDK 버전을 함께 점검해야 최적의 효과를 볼 수 있습니다.
Q2. 기존에 사용하던 NVIDIA Device Plugin을 즉시 버려야 하나요?
아닙니다. 기존 Device Plugin 아키텍처도 하위 호환성 차원에서 정상 동작합니다. 다만 v1.35부터 DRA가 GA로 공식 표준화됨에 따라, 향후 정밀한 GPU 슬라이싱과 다중 노드 토폴로지 인지 스케줄링을 도입하기 위해 점진적으로 DRA 드라이버 환경을 스테이징에서 테스트해 보시는 것을 권장합니다.
Q3. 클러스터 업그레이드 시 권장되는 접근 방식은 무엇인가요?
쿠버네티스는 n-1 마이너 버전 호환성을 보장하므로 컨트롤 플레인을 먼저 v1.35로 승격한 후, 워커 노드 풀을 순차적으로 롤링 업데이트하는 카나리(Canary) 노드 그룹 방식을 추천합니다. 특히 노드 OS의 Cgroup v2 활성화 여부를 사전에 반드시 확인해야 핵심 기능들을 온전히 누릴 수 있습니다.
📌 Kubernetes v1.35 최종 핵심 요약 카드
- 핵심 성과: 동적 리소스 할당(DRA) GA 정식 채택 & In-Place 파드 수직 스케일링 완성
- 운영 효율: 재시작 없는 리소스 증감으로 피크 타임 다운타임 제로화 및 GPU 비용 절감
- 총평: 복잡한 AI 가속기 워크로드와 대규모 엔터프라이즈 마이크로서비스를 안정적으로 품어내는 차세대 클라우드 오케스트레이션 필수 릴리스!
※ 본 포스팅은 CNCF 공식 릴리스 노트 및 쿠버네티스 오픈소스 기여 문서를 기반으로 작성되었습니다. 상용 클러스터 적용 전 스테이징 노드 풀에서 Cgroup v2 및 CRI 런타임 호환성을 반드시 사전 검증하시기 바랍니다.
아직 댓글이 없습니다. 첫 댓글을 남겨보세요!